
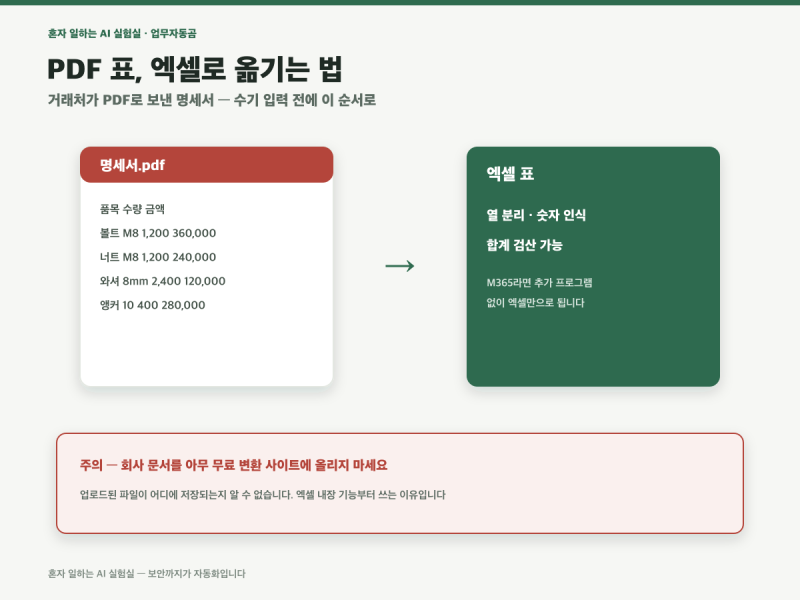
PDF 파일을 엑셀로 변환하는 방법은 회사나 학교 업무에서 빈번하게 요구되는 작업입니다. 특히 재무 보고서나 통계 수치 등 중요한 데이터를 PDF 형태로 전달받았을 때, 이를 엑셀에서 분석하고 가공하기 위해 변환하는 과정이 필수적입니다. 최신 엑셀 버전에서는 별도의 프로그램 없이도 PDF 파일 내의 표 데이터를 깔끔하게 불러올 수 있는 고성능 데이터 엔진이 내장되어 있어 사용자들의 편의를 높였습니다.
많은 사용자가 PDF 파일의 표를 단순히 복사하여 엑셀에 붙여넣기 할 경우, 데이터가 한 셀에 뭉개지거나 행과 열의 구분이 사라지는 문제에 직면합니다. 이는 PDF가 문서 출력용으로 설계된 반면 엑셀은 격자형 스프레드시트 구조를 가지기 때문에 발생하는 근본적인 차이 때문입니다. 하지만 엑셀의 내장 기능을 활용하면 이러한 서식 깨짐 없이 정확하게 표 데이터를 추출할 수 있으며, 파워쿼리 편집기를 통해 불필요한 행을 제거하고 데이터를 자동 정렬하는 고급 기능도 활용 가능합니다.
PDF 파일을 엑셀로 변환할 때는 단순히 데이터를 가져오는 것을 넘어, 원본 PDF의 서식을 최대한 유지하면서 효율적으로 작업하는 것이 중요합니다. 특히 복잡한 표나 병합된 셀이 포함된 문서의 경우, 엑셀의 데이터 가져오기 기능을 통해 표 레이아웃을 보존하는 방법을 익히는 것이 실무 속도를 높이는 데 큰 도움이 됩니다. 또한, 변환 전용 단축키를 활용하면 더욱 신속하게 작업을 완료할 수 있습니다.